
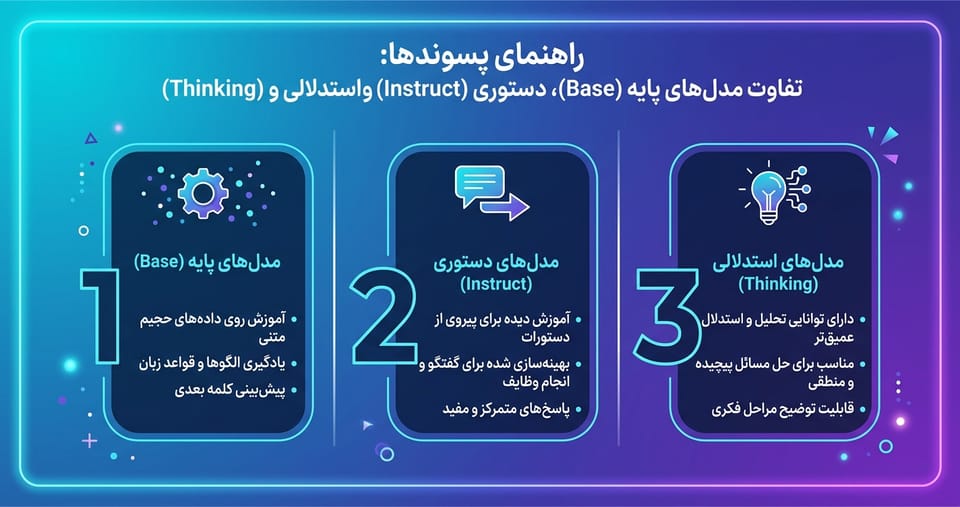
راهنمای پسوندها: تفاوت مدلهای پایه (Base)، دستوری (Instruct) و استدلالی (Thinking)
تصور کنید وارد منوی انتخاب مدل در پلتفرم هوش مصنوعی خود میشوید تا مدل مورد نظرتان را انتخاب کنید. ناگهان با نامهای مشابهی مواجه میشوید که فقط پسوندهای متفاوتی دارند: یکی به پسوند Instruct ختم میشود، دیگری Thinking است، یکی هیچ پسوندی ندارد و مدل دیگری در همان خانواده پسوند it یا Coder یا VL دارد.
در دو سال گذشته، توسعهدهندگان به خوبی با تعداد پارامترهای مدلها (مانند 8B یا 70B) آشنا شدهاند، اما این پسوندهای جدید هنوز برای بسیاری مبهم هستند. واقعیت این است که این پسوندها اهمیتی حیاتی دارند؛ دو مدل با تعداد پارامتر کاملاً یکسان اما با پسوندهای متفاوت، میتوانند ابزارهای کاملاً متفاوتی برای کار شما باشند.
در این مقاله، ما به کالبدشکافی کامل این نامگذاریها میپردازیم تا بتوانید با دیدی کاملاً روشن، مدل مناسب برای سناریوی خود را انتخاب کنید و از فاکتورهای سرسامآور هزینهها جلوگیری کنید.
کالبد نامگذاری مدلها: سه محور اصلی
سیستم نامگذاری مدلها شاید در نگاه اول آشفته و سلیقهای به نظر برسد، اما در واقع از یک منطق سازگار و مشخص پیروی میکند. هر پسوند معمولاً به یکی از سه سؤال زیر پاسخ میدهد: ۱. مرحله آموزش مدل (Training Stage):checkpoint ارائه شده نماینده کدام مرحله از چرخه آموزش است؟ ۲. تخصصیسازی (Specialization): مدل برای چه حوزه یا کار خاصی بهینهسازی شده است؟ ۳. نحوه سرویسدهی و اجرا (Serving): وزنهای مدل چگونه اجرا و کوانتایز شدهاند؟
در این راهنما، تمرکز اصلی ما روی محور اول (مراحل آموزش) است، زیرا این محور مستقیماً ماهیت رفتاری و عملکردی مدل را تغییر میدهد.
۱. مدلهای پایه (Base): یک ادامهدهنده متن، نه یک دستیار!
هر خانواده از مدلهای زبانی با یک مدل پایه (Base Model) آغاز میشود. این مدل، خروجیِ مستقیم مرحله پیشآموزش (Pretraining) روی حجم عظیمی از دادههای متنی است. برخی از شرکتها مانند Qwen این مدلها را به طور واضح با پسوند -Base مشخص میکنند، در حالی که برخی دیگر هیچ پسوندی برای مدل پایه قرار نمیدهند و فقط به مدل دستوری پسوند اضافه میکنند. به همین دلیل، نبود پسوند در یک خانواده میتواند به معنای مدل پایه باشد و در خانوادهای دیگر به معنای مدل دستوری!
کارکرد مدل پایه بسیار ساده و در عین حال محدود است: پیشبینی توکن بعدی بر اساس توکنهای قبلی. این مدلها مفهوم «چت»، «نوبت کاربر (User Turn)» یا «دستیار پاسخگو» را متوجه نمیشوند.
خطای کلاسیک مدلهای پایه در چت
اگر از یک مدل پایه بپرسید:
"سه علت اصلی پر شدن استخر اتصالات پایگاه داده (Database Connection Pool) چیست؟"
پاسخ مدل پایه به احتمال زیاد لیستی از سوالات چهارم، پنجم و ششم در همان سبک خواهد بود! مثلاً مینویسد: "چگونه میتوان این اتصالات را مانیتور کرد؟ چطور سایز استخر را تنظیم کنیم؟" چرا؟ چون از نظر آماری، قرار گرفتن سوالات مشابه پشت سر هم در اینترنت یک ادامه کاملاً منطقی برای سوال شماست. مدل دقیقاً همان کاری را انجام میدهد که برایش آموزش دیده است، اما این رفتار برای یک چتبات کاملاً نامناسب است.
پس چرا مدلهای پایه منتشر میشوند؟
- نقطه شروع ایدهآل برای فاینتیون شخصی: اگر میخواهید مدل را روی دادههای اختصاصی خود آموزش دهید، مدل پایه بهترین گزینه است.
- کارهای مبتنی بر تکمیل متن (Completion): فرآیندهایی مانند تکمیل خودکار کد در وسط خطوط (Fill-in-the-Middle) ذاتاً از جنس ادامهدهندگی متن هستند و مدلهای پایه یا مدلهای سبک بهینهشده برای این کار، گزینههای بهتری نسبت به مدلهای چت به شمار میروند.
۲. مدلهای دستوری (Instruct): انتخاب پیشفرض برنامههای کاربردی
مدل دستوری یا Instruct (که با پسوندهای -Instruct در مدلهای متا، Qwen و میسترال، یا -it در سری Gemma گوگل و یا -chat در نسخههای قدیمیتر شناخته میشود) همان مدل پایه است که تحت فرآیند تنظیم دستورالعمل (Instruction Tuning) قرار گرفته است. این فرآیند شامل آموزش نظارتشده روی جفتهای «پرامپت و پاسخ مناسب» (Supervised Fine-Tuning) و به دنبال آن بهینهسازی ترجیحات انسانی از طریق یادگیری تقویتی (RLHF) است.
نتیجه این آموزشها مدلی است که:
- ساختار پیامهای چت (چت تمپلیت) را متوجه میشود.
- به سوال پرسیده شده پاسخ مستقیم میدهد.
- الزامات فرمتدهی (مانند خروجی JSON) را به خوبی رعایت میکند.
- درخواستهای غیرمجاز و خطرناک را رد میکند.
نکته کاربردی: وقتی یک API میزبانیشده مدلی را بدون هیچ پسوندی لیست میکند، به احتمال بسیار زیاد در حال ارائه نسخه Instruct است، چرا که این نسخهای است که برنامهها واقعاً میتوانند از آن استفاده کنند. همچنین به یاد داشته باشید که قالب چت (Chat Template) هر مدل با مدل دیگر متفاوت است و به همین دلیل یک پرامپت یکسان ممکن است رفتارهای متفاوتی در خانوادههای مختلف نشان دهد.
برای اکثر کارهای تولیدی مانند سیستمهای RAG (بازیابی اطلاعات)، خلاصهسازی، استخراج داده و دستهبندی (Classification) و فراخوانی ابزارها (Tool Calling)، مدلهای دستوری بهترین و اقتصادیترین گزینه هستند.
۳. مدلهای استدلالی (Thinking): پرداخت هزینه برای تفکر، نه فقط پاسخ بهتر
جدیدترین و داغترین پسوند در دنیای هوش مصنوعی، Thinking یا همان مدلهای استدلالی (Reasoning) است. نمونههای بارز آن سری o-series OpenAI، مدل DeepSeek R1 و مدلهای Thinking خانواده Qwen هستند.
یک مدل استدلالی در واقع یک مدل دستوری است که آموزش دیده تا قبل از ارائه پاسخ نهایی، یک زنجیره تفکر داخلی (Internal Chain of Thought) تولید کند. در مسائلی که نیاز به گامهای میانی دارند (مانند ریاضیات پیچیده، برنامهریزی چندشرطی، یا عیبیابی کدهای سخت)، این تفکر داخلی منجر به دقتی میشود که مدلهای معمولی در یک پاس رو به جلو هرگز به آن دست نمییابند.
آیا مدلهای استدلالی همیشه بهترند؟
سوال اصلی این نیست که آیا این مدلها قویترند یا خیر، بلکه این است که: آیا خطاهای سیستم شما با تفکر عمیق حل میشوند؟
- چه زمانی از Thinking استفاده کنیم؟ اگر بررسی خطاهای شما نشان میدهد که مدل پاسخهای اشتباهی میدهد چون گامهای حل مسئله را جا انداخته است (مثلاً در یک فرآیند عیبیابی فاکتور مهمی را نادیده گرفته یا در محاسبات میانی اشتباه کرده)، مدل استدلالی را انتخاب کنید.
- چه زمانی تفکر عمیق هدر دادن پول است؟ اگر خطاهای مدل به خاطر نبود دانش در پایگاه داده شما، مبهم بودن دستورالعملها، یا بازیابی بد اطلاعات در سیستم RAG است، تفکر بیشتر هیچ کمکی به مدل نمیکند. در این سناریوها، استفاده از مدل استدلالی فقط هزینه شما را به شدت بالا میبرد.
محاسبات هزینههای پنهان مدلهای استدلالی
توکنهای بخش استدلال (Trace Tokens) مانند توکنهای معمولی تولید میشوند و پلتفرمها هزینه آنها را با تعرفه توکن خروجی (Output Token Rate) حساب میکنند؛ حتی اگر پلتفرم این توکنها را در خروجی نهایی به کاربر نشان ندهد!
بیایید یک محاسبه ساده انجام دهیم: فرض کنید قیمت هر میلیون توکن خروجی ۱ دلار باشد.
- یک پاسخ مستقیم و ۴۰ توکنی بدون استدلال: ۰.۰۰۰۰۴ دلار هزینه دارد.
- همان پاسخ ۴۰ توکنی که پشت آن ۱۵۰۰ توکن استدلال تولید شده است: ۰.۰۰۱۵۴ دلار هزینه دارد.
این یعنی ۳۸ برابر افزایش هزینه برای همان پاسخ! در حجم تراکنشهای بالا، روشن گذاشتن پیشفرض مدل استدلالی به سرعت به بزرگترین بند فاکتور شما تبدیل میشود. علاوه بر هزینه، زمان تولید این توکنهای استدلال باعث افزایش چشمگیر تاخیر (Latency) میشود.
خطر بزرگ: لیمیت توکن خروجی (max_tokens)
یک چالش فنی بسیار رایج با مدلهای استدلالی وجود دارد: تداخل با محدودیت max_tokens. اگر سقف توکن خروجی را خیلی کم (مثلاً ۶۰ توکن) تنظیم کنید، مدل تمام این ظرفیت را صرف نوشتن فرآیند استدلال میکند و قبل از اینکه بتواند پاسخ نهایی را بنویسد، ظرفیتش تمام میشود. در این حالت شما یک پاسخ خالی با علت پایان finish_reason: length دریافت میکنید. برای حل این مشکل باید سقف توکن خروجی را افزایش دهید یا از قابلیتهای تنظیم میزان استدلال (Effort Controls) استفاده کنید.
رویکرد ترکیبی (Hybrid Design): امروزه مرز بین مدلها در حال محو شدن است. بسیاری از پلتفرمها پارامتری به نام reasoning_effort یا کنترل توکن استدلال ارائه میدهند که به شما اجازه میدهد در سطح هر درخواست (Request-time) مشخص کنید مدل چقدر فکر کند. این یعنی انتخاب مدل و عمق استدلال به دو تصمیم مجزا تبدیل شدهاند.محورهای تخصص و سرویسدهی در یک نگاه
علاوه بر مرحله آموزش، دو محور دیگر نیز در نامگذاری وجود دارند که دانستن آنها به شما در انتخاب ابزار مناسب کمک میکند:
الف) محور تخصص (Specialization Suffixes)
این پسوندها نشاندهنده تغییر ماهیت کاربری مدل هستند و نه سطح کیفیت آن:
- Coder / Math: بهینهسازی شده برای برنامهنویسی یا ریاضیات.
- VL / Vision: مدلهای چندوجهی که ورودی تصویر را نیز میپذیرند.
- Omni / Audio / Realtime: مدلهای چندوجهی با قابلیت پردازش مستقیم صدا و تعامل زنده.
- Guard: مدلهای امنیتی که برای دستهبندی و پایش ایمنی محتوا استفاده میشوند.
ب) محور سرویسدهی و بهینهسازی (Serving Variants)
این پسوندها نحوه اجرا و فشردهسازی مدل را توصیف میکنند:
- fp8 / AWQ / GGUF: فرمتهای مختلف کوانتایزیشن (کاهش دقت وزنها برای سبک شدن مدل و اجرای سریعتر با افت دقت ناچیز).
- turbo: نسخههای بهینهشده توسط ارائهدهندگان برای سرعت بالاتر.
- distill: مدلهای کوچکتری که آموزش دیدهاند تا رفتار یک مدل بزرگتر (مدل معلم) را تقلید کنند.
کالبدشکافی ۵ نام واقعی
بیایید دانشی که به دست آوردیم را روی ۵ نام واقعی که احتمالاً در لیستها دیدهاید پیاده کنیم:
۱. gemma-4-31b-it
خانواده Gemma نسل چهارم، ۳۱ میلیارد پارامتر، پسوند it مخفف Instruct-tuned (نامگذاری گوگل برای مدل دستوری). این همان مدلی است که باید برای چتبات خود استفاده کنید.
۲. Llama-3.1-70B در برابر Llama-3.1-70B-Instruct
متا مدلهای پایه خود را بدون پسوند عرضه میکند. مدل اول یک مدل پایه (Base) و ادامهدهنده متن است و مدل دوم نسخه دستوری. ارزیابی اشتباه مدل پایه به جای مدل دستوری یکی از رایجترین اشتباهات توسعهدهندگان است.
۳. DeepSeek-R1-Distill-Qwen-32B
یک مدل ۳۲ میلیارد پارامتری از خانواده Qwen که با استفاده از تکنیک تقطیر (Distillation) روی دادههای استدلالی DeepSeek R1 فاینتیون شده است. این مدل مثل R1 فکر میکند اما سقف تواناییهای آن محدود به اندازه ۳۲ میلیاردی خودش است.
۴. gpt-4o-mini و gemini-2.5-flash-preview
مدلهای اختصاصی شرکتهای بزرگ معمولاً از پسوندهای اندازه (mini یا flash) استفاده میکنند. پسوند preview یک نشانگر چرخه عمر (Lifecycle Marker) است که هشدار میدهد این نقطه اتصال ممکن است در آینده تغییر کند یا حذف شود. این مدلها پسوند Instruct ندارند زیرا پلتفرمها به طور پیشفرض نسخه دستوری را ارائه میدهند.
۵. Qwen3.5-122B-A10B-Instruct-fp8
تمام محورها در یک نام! خانواده Qwen نسخه ۳.۵، دارای ۱۲۲ میلیارد پارامتر کلی که در هر توکن ۱۰ میلیارد آن فعال میشود (معماری مخلوطی از متخصصان یا MoE)، تنظیم شده برای دستورات (Instruct) و ارائه شده با دقت فشردهسازی شده ۸ بیتی (fp8).
راهنمای انتخاب: کدام مدل برای کدام کار؟
جدول زیر خلاصهای کاربردی برای تصمیمگیری در سناریوهای مختلف است:
| سناریو / تسک | مدل مناسب | چرا؟ |
|---|---|---|
| پشتیبانی مشتری، دستیارهای عمومی و چت | Instruct | رعایت لحن، فهم ساختار چت و پایبندی به اصول اخلاقی و رفتاری. |
| سیستمهای RAG روی اسناد | Instruct | ترکیب اطلاعات بر اساس سند نیاز به فهم دستورالعمل دارد. مدل استدلالی را فقط برای سوالات چندمرحلهای (Multi-hop) بسیار سخت استفاده کنید. |
| استخراج داده، دستهبندی و ساختاردهی خروجی | Instruct | چالش اصلی در اینجا مطابقت با فرمت است و تفکر عمیق هزینه زیادی بدون افزایش دقت ایجاد میکند. |
| عاملهای هوشمند (Agents) و چرخههای ابزار | ترکیبی (Instruct + Thinking) | بیشتر گامهای عاملها کارهای روتین هستند (Instruct). تفکر عمیق (Thinking) را فقط برای گامهای برنامهریزی سخت فعال کنید. |
| ریاضیات سخت و اثبات فرمولها | Thinking | بدون زنجیره تفکر داخلی، رسیدن به پاسخ درست تقریباً غیرممکن است. |
| عیبیابی کدهای پیچیده و برنامهریزی بلندمدت | Thinking (با بافر توکن بالا) | قطع شدن مسیر تفکر به دلیل کمبود توکن، کیفیت خروجی را در این تسکها به شدت تخریب میکند. |
| تکمیل خودکار کد (وسط خطوط) | Base یا مدل پایه تخصصی کد | ماهیت این کار ادامه دادن متن است و قالبهای چت در آن اختلال ایجاد میکنند. |
| فاینتیون روی دادههای اختصاصی | Base | شروع از مدل Instruct باعث به ارث رسیدن قالب چت و محدودیتهای رد درخواست آن میشود که ممکن است مطلوب شما نباشد. |
۵ اشتباه متداولی که باید از آنها دوری کنید
۱. اتصال برنامه چت به مدل پایه: خروجیها به شدت خراب شده و مدل دچار انحراف شدید میشود. راهکار: حتماً از پسوند Instruct یا it استفاده کنید. ۲. استفاده از مدل استدلالی به عنوان پیشفرض به خاطر بنچمارک بالا: بنچمارکهای بالای مدلهای استدلالی مربوط به مسائل ریاضی و منطقی سخت است. در کارهای ساده چت یا خلاصهسازی، مدل استدلالی فقط هزینه ترایسهای طولانی را به شما تحمیل میکند در حالی که خروجی آن تفاوتی با مدل دستوری ندارد. ۳. تنظیم محدودیت شدید توکن خروجی برای مدل استدلالی: تمام بودجه توکن صرف استدلال شده و خروجی نهایی خالی برمیگردد. ۴. ارزیابی یک نسخه و دیپلوی نسخه دیگر: تست کردن نسخه Instruct و دیپلوی کردن نسخه turbo یا تغییر دادن snapshot تاریخدار به نسخه latest بدون ارزیابی مجدد، رفتارهای پیشبینینشدهای ایجاد میکند. ۵. اشتباه گرفتن مدل تقطیر شده (Distill) با مدل اصلی: مدلهای تقطیر شده سبک مدل معلم را تقلید میکنند اما سقف توانایی پایینی دارند. نباید انتظار کیفیت کامل مدل بزرگتر را از آنها داشت.
نتیجهگیری: هنر مسیردهی هوشمند مدلها (Model Routing)
استفاده از یک مدل واحد برای تمام بخشهای یک نرمافزار بزرگ، همواره با سازش و قربانی کردن کارایی همراه است. اگر یک مدل قوی و گرانقیمت مثل GPT-4 یا Claude 3.5 را به عنوان پیشفرض قرار دهید، در کارهای ساده مانند دستهبندی بلیتها هزینهای ۱۰ برابری پرداخت میکنید. اگر یک مدل ارزان و کوچک انتخاب کنید، در تحلیلهای سخت شکست میخورید. و اگر مدل استدلالی را پیشفرض کنید، فاکتورهای شما سرسامآور خواهند شد.
Member discussion